Секунда до ответа: куда уходит время между вопросом и первым словом
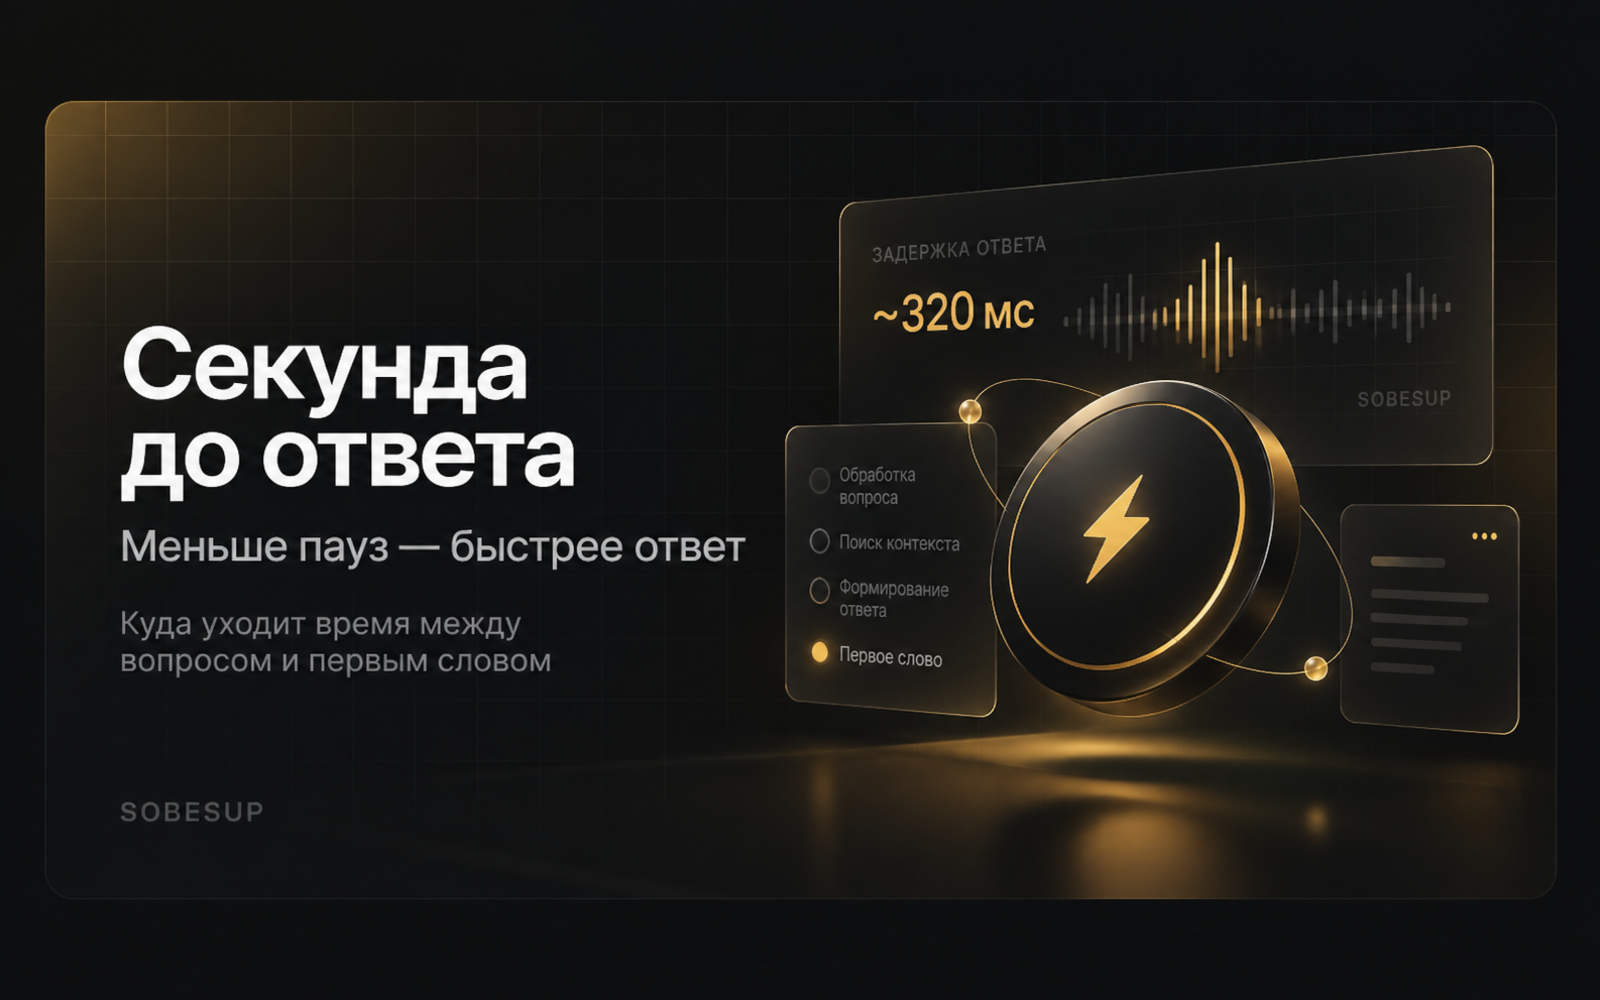
На собеседовании есть неписаный таймер. Пауза до секунды выглядит как «собираюсь с мыслями», пауза в три секунды уже читается как «не знаю». Причём интервьюер делает этот вывод раньше, чем вы произнесёте первое слово. Поэтому у ассистента, который подсказывает во время разговора, одна метрика важнее всех остальных: время от конца вопроса до первого полезного слова на экране. Ниже про то, из чего эта секунда складывается.
Путь одного вопроса
- Интервьюер задаёт вопрос. Звук из динамиков захватывается кадрами по 100 миллисекунд.
- Кадры с речью уходят на сервер и дальше в распознавание. Приходят промежуточные результаты.
- Провайдер распознавания сообщает, что фраза закончилась.
- Быстрая модель за один короткий запрос восстанавливает вопрос после ошибок распознавания и определяет его тип.
- Основная модель пишет ответ и отдаёт его потоком, слово за словом.
- Окно показывает текст по мере поступления.
Каждый пункт стоит времени, и в первой версии продукта они складывались в неприличную сумму. Дальше по порядку, что мы с этим сделали.
Распознавание: не ждать лишнего
Самая большая потеря была в третьем пункте. Провайдеры распознавания осторожны: они помечают фразу финальной только после уверенной паузы, потому что боятся разрезать предложение пополам. Для субтитров это правильно. Для нас каждая лишняя сотня миллисекунд ожидания съедает бюджет паузы.
Помогло то, что вопрос не обязан быть идеально распознан, чтобы по нему начать работать. Промежуточные результаты приходят раньше финальных, и следующий этап умеет чинить огрехи. Поэтому мы стали доверять концу фразы от провайдера, но не ждать после него его же поздних правок: если распознавание через полсекунды уточнит слово, буфер обновит транскрипт, а ответ уже будет на экране.
Две модели вместо одной
Интуитивно кажется, что дополнительный запрос к модели перед основным только замедлит систему. На практике вышло наоборот. Маленькая быстрая модель отвечает на простые вопросы «что здесь спросили, какого это типа и нужно ли для ответа резюме» за долю секунды. Зато основная модель получает чистый нормализованный вопрос и только тот контекст, который ей нужен. Меньше входных данных, быстрее первый токен, и ответ по существу, а не по всему подряд.
Быстрая модель заодно решает, какую основную модель звать. Для определений и коротких сравнений хватает лёгкой, для кода и вопросов на несколько уровней вглубь нужна сильная. Режим Auto делает этот выбор сам, и большинство вопросов на интервью проходят по быстрой ветке.
Первое предложение важнее всего ответа
Ответ идёт потоком, поэтому его структура влияет на ощущение скорости не меньше, чем задержка сети. Мы пишем ответ так, чтобы первая строка была самодостаточной: одно предложение, которое можно произнести сразу. Затем тезисы, затем пояснение. Если вы прочитали только первую строку и начали говорить, вы уже отвечаете правильно, а остальное догрузится, пока вы произносите первую фразу.
Где мы сознательно проиграли
Скорость имеет цену, и мы хотим быть честными про неё.
- Иногда конец фразы срабатывает на паузе в середине вопроса. Тогда ответ начнётся по половине. Для этого есть клавиша «ответить ещё раз»: она берёт полный текст и запускает ответ заново, а уточнение интервьюера распознаётся как продолжение, а не новый вопрос.
- Промежуточный текст распознавания иногда выглядит странно, пока не пришла правка. Мы показываем его как есть: лучше видеть, что услышал ассистент, чем ждать красивой версии.
- Мы не отправляем звук на распознавание до того, как кто-то заговорил. Порог тишины даёт крошечную задержку на первом слове, но экономит деньги на каждой минуте молчания.
Как это проверить самому
В приложении есть режим проверки перед созвоном: включите любой ролик с интервью на YouTube и смотрите, когда появляется первая строка ответа. Это честнее любых наших цифр, потому что ваш интернет, ваш звук и ваши вопросы.